
Day6 看到 Pi 照著 AGENTS.md 把一個 API 做對了。但這只是一次執行——換個時間再跑,它可能漏掉一個註冊點;拿掉 AGENTS.md,它可能也照樣做對。只看一次,什麼結論都下不了。
Day1 承諾過:這系列每一個「更好」都要能被重跑驗證。今天就來兌現這個承諾的第一步——搭一個量測台。
程式碼和之後所有實驗數據都公開在 howisyour/my_first_pi_agent_project。
我寫了一個小型的任務管理 API(taskapp),約 60 個檔案,裡面刻意埋了五個「專案慣例」:
| 慣例 | 違反的後果 |
|---|---|
真正的驗收是 python scripts/check.py,python -m pytest 只跑單元測試 |
只跑 pytest 會以為全過 |
新增 endpoint 要改三處:route、schema 匯出、ROUTE_REGISTRY |
少一處就回 404 或 500 |
預期中的錯誤一律 raise AppError 子類 |
裸 ValueError 會變成 500 |
models_generated.py 禁止手改,要改 schema 再重新產生 |
雜湊值對不上,檢查失敗 |
| routes/services 不能出現 0、1、-1 以外的數字 | 檢查會掃出來 |
設計這些慣例時,最重要的原則是:找得到,但要付出成本。
如果完全找不到,沒有 AGENTS.md 的那組會全部失敗(地板效應);如果太明顯,兩組都全部成功(天花板效應)。兩種情況都量不出差異。所以每一個慣例都寫在 README 或 docs/ 裡,認真讀的 agent 找得到——只是要多花幾輪去讀。
任務不是隨便挑的。每個任務都是為了量某一個元件設計的:
| 任務 | 想量的元件 | 內容 |
|---|---|---|
| T1 修分頁 bug | 對照組 | 單純修一個邊界 bug |
| T2 新增 endpoint | AGENTS.md | 要改三處才會通 |
| T3 修 CI 檢查 | AGENTS.md | pytest 是綠的,問題只有 check.py 看得到 |
| T4 拆常數 | 搜尋工具 | 把散在 6 個檔案的常數拆成兩個 |
| T5 資料遷移 | Skills | 照專案的六步驟流程新增欄位 |
每個任務除了 check.py,還有一組 agent 看不到的隱藏測試。例如 T2 的隱藏測試會先改掉某個任務的狀態再查統計,確認數字是真的算出來的,而不是照規格寫死。
還有一個一定要處理的漏洞:agent 可能為了讓測試通過去改測試本身。所以驗收之前,量測台會先比對 check.py、tests/、pyproject.toml 這些受保護的檔案有沒有被動過——有就記錄下來,然後還原成原本的版本再驗收。改測試是過不了關的。
最後判定只看 exit code:check.py 通過、隱藏測試通過,才算成功。
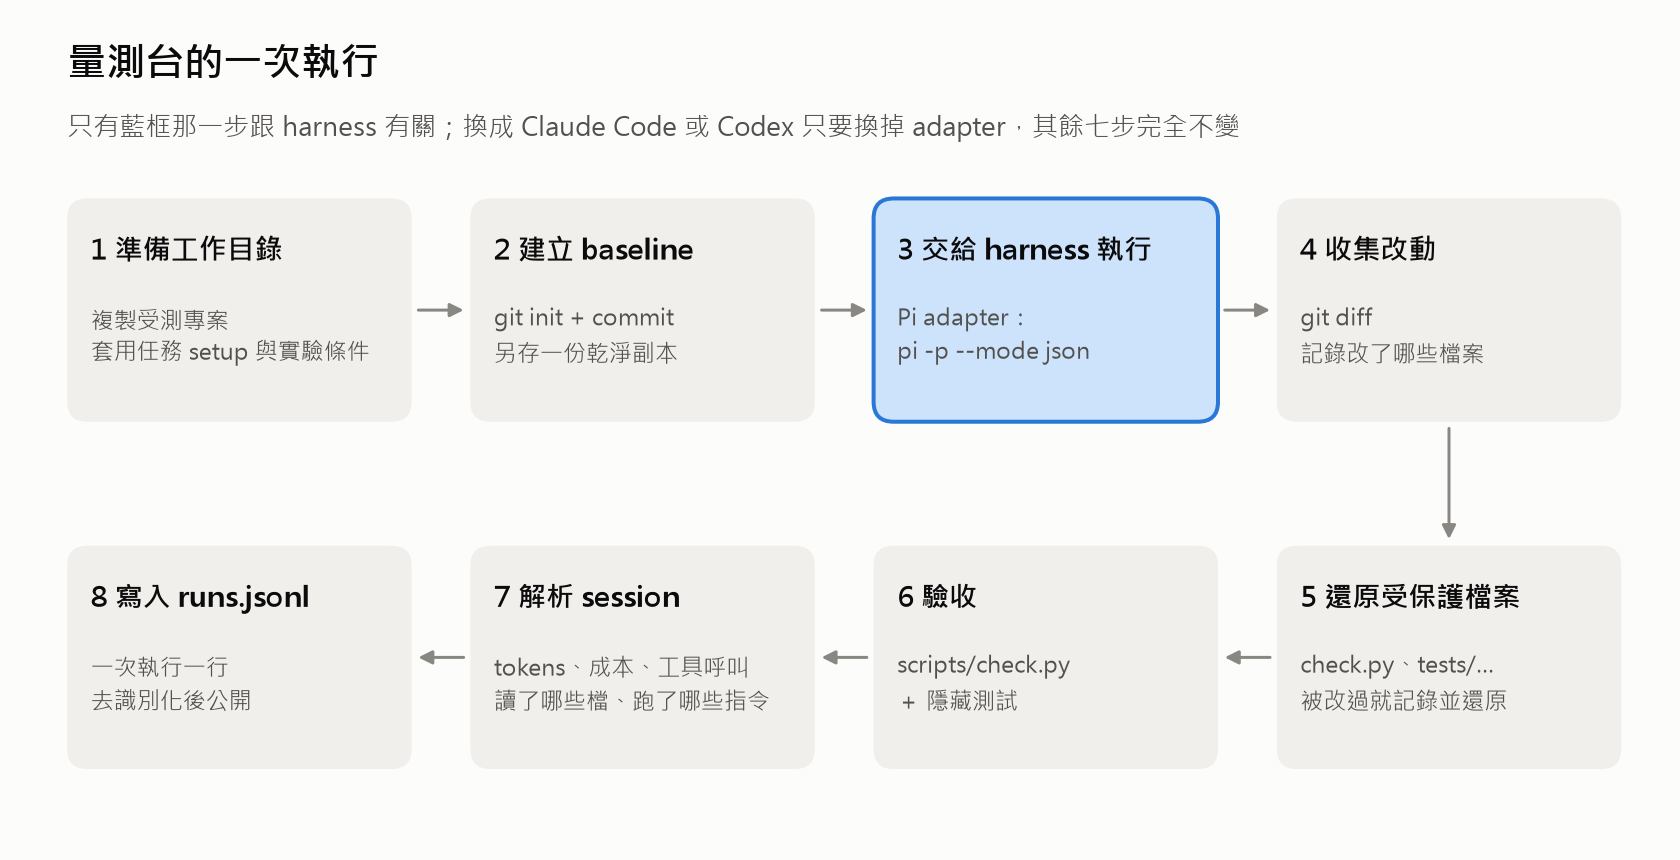
八個步驟裡,只有第三步跟 harness 有關。量測台只要求 harness 提供這個介面:
class HarnessAdapter(Protocol):
    name: str

    def version(self) -> str: ...

    def run(self, workdir: Path, prompt: str, condition: Condition, run_dir: Path, timeout: int) -> AgentRun: ...
給它一個工作目錄、一段 prompt、這次的實驗條件,它回傳 exit code 和 session 記錄的位置。任務、條件、驗收全部跟 harness 無關,寫一個 Claude Code 或 Codex 的 adapter,就能跑同一組任務互相比較。
Pi 的 adapter 實際下的指令長這樣:
pi -p --mode json \
  --no-extensions --no-skills --no-prompt-templates --no-themes \
  --session-dir <這次執行的目錄>/session \
  --model openai-codex/gpt-5.6-luna --thinking medium \
  -- "<任務 prompt>"
那一串 --no-* 很重要:它把我電腦上可能存在的全域 extension、skill、prompt 範本全部關掉,只有實驗條件明確指定的東西才會被載入。否則「有沒有某個元件」這個變數根本控制不住。
同樣的理由,每次執行都在一個獨立的資料夾進行,而且這個資料夾本身是一個獨立的 git repo。Pi 會往上層目錄找 AGENTS.md、往上找到 git 根目錄為止搜尋 skills,隔離在獨立 repo 裡,就不會意外撿到別的專案的設定。
量測台也是程式,也會有 bug。在花任何一分錢跑 agent 之前,我先讓它對每個任務做兩件事:
[PASS] clean fixture passes scripts/check.py
[PASS] t1_fix_pagination: baseline 失敗於 pytest,參考解成功
[PASS] t2_add_endpoint:   baseline 失敗於 pytest 與 3 個隱藏測試,參考解成功
[PASS] t3_fix_check:      baseline 失敗於 ruff、pytest、raise_scan、magic_numbers,參考解成功
[PASS] t4_split_constant: baseline 失敗於 4 個隱藏測試,參考解成功
[PASS] t5_migration:      baseline 失敗於 5 個隱藏測試,參考解成功
這一步抓到了我自己寫的 check.py 有幾行太長、被它自己的 lint 規則擋下來——如果沒先跑這個自我檢查,第一批實驗會全部被判失敗,而我可能會以為是 agent 的問題。
每次執行會在 experiments/results/<實驗>/runs.jsonl 寫一行記錄,主要欄位:
success、失敗在 check.py 的哪一關、哪些隱藏測試沒過、有沒有動到受保護檔案check.py、有沒有讀 SKILL.md
另外還會保留完整的 session 記錄與 git diff。公開之前,記錄裡的本機路徑、使用者名稱、電腦名稱都會被換成 <HOME>、<user>、<host> 這類代號。
幾個實作上的小決定:
runs.jsonl 的執行會被跳過。第一批校準跑下來,我踩到兩種「看起來是失敗,其實跟 agent 無關」的狀況:
如果量測台把這些當成 agent 做錯,就會畫出「某個條件成功率 0%」這種完全錯誤的圖。所以我加了一條規則:模型一輪都沒回應、只有錯誤回應、或事件串流連續 420 秒沒有任何輸出,就判定為基礎設施失敗。這類執行會被移到另一個檔案(不刪除),然後重跑,並在結果表格下方註明有幾次是重跑的。
420 秒這個數字是刻意選的:Pi 自己的 HTTP 閒置逾時是 300 秒,逾時後會自己重試,量測台要給它自救的機會,而不是搶先把它砍掉。
量測台的第一次正式執行是 T1(修分頁 bug):成功,8 次工具呼叫,成本 0.0026 美元,耗時 105 秒,完成前有照 AGENTS.md 跑 check.py。
還有一個意外的發現:Pi 預設只開 read、bash、edit、write 四個工具,grep、find、ls 這些搜尋工具預設是關的。但這次執行裡,agent 直接透過 bash 用了 rg 和 find。關掉一個工具,不代表 agent 就沒有那個能力——它會繞路。原本大綱寫的 Day13「拿掉 grep/find/ls 的代價」,因此要改成「加上 grep/find/ls 有沒有差」,而且要把透過 bash 繞路的次數一起量進去。
量測台搭好了,接下來進入第一輪「拆一個元件、隔天量它」。Day8 先拆 AGENTS.md:Pi 從哪些地方載入它、多個檔案之間怎麼決定誰覆蓋誰,以及它最後是怎麼進到模型眼前的。


您的文章非常精采,但我有一些問題想問您
重複次數與隨機性:「文中提到第一次校準跑了 30 次執行,想請問後續針對單一任務在不同條件(如有/無 AGENTS.md)下,預計各跑幾次(N 等於多少)來判定成功率差異?對於 LLM 本身輸出的隨機性,有預計採用哪些統計檢定(例如 Fisher's exact test)或信心區間來支撐結論嗎?」
Prompt 洩漏與難度調校:「任務描述(Prompt)本身是如何設計的?如果 prompt 裡提到『請遵循專案慣例』,會不會引導模型主動去看 README;反之若只給最精簡的 issue 描述,會不會造成所有條件都掉入地板效應?」


 iThome鐵人賽
 看影片追技術